Van boekenkast naar scanstraat: mijn zelfgehoste boekscanner
Intro
Een boek toevoegen aan je bibliotheek klinkt simpel, totdat je de titel, auteur, uitgever en het ISBN zelf moet overtypen. En bij een boek dat je al in handen hebt, liggen de belangrijkste gegevens vaak gewoon voor je: op de kaft, naast de barcode en in het colofon.
Daarom bouwde ik een boekscanner die van een paar foto's een boekrecord maakt. Ik fotografeer de voorkant; de app probeert de gegevens te herkennen en zoekt het ISBN op. Daarna kan ik de achterkant of het colofon toevoegen om de details aan te vullen.
Niet zo technisch? Klik hier voor de simpele uitleg
Dit is de korte versie in gewone taal.
1. Het probleem
Boeken invoeren kost tijd. Je moet gegevens overtypen en foto's los bewaren, terwijl veel informatie al op de kaft en in het boek staat.
2. De oplossing
Ik fotografeer een boek met mijn telefoon. De app leest de kaft, herkent een barcode en haalt aanvullende gegevens op. Een foto van het colofon kan bijvoorbeeld de uitgever, druk en vertaler opleveren.
3. Niet blind vertrouwen op AI
De app bewaart waar een gegeven vandaan komt. Mijn eigen aanpassingen gaan nooit verloren, en bij twijfel over een koppeling vraagt de app eerst om controle.
4. Alles blijft thuis
De app draait op mijn eigen server. De herkenning gebeurt met lokale software en een vision-model op mijn netwerk; er is geen externe AI-dienst nodig.
TL;DR: Een zelfgehoste PWA met FastAPI, SQLAlchemy en SQLite als backend en Svelte 5 + TypeScript als frontend. Barcodeherkenning, OCR en een vision-model vullen elkaar aan. Foto's blijven origineel bewaard, gegevens hebben een bron per veld en onzekere matches komen eerst in een inbox. De app is bedoeld voor thuisnetwerk of VPN en heeft bewust geen login.
Fotograferen in stappen
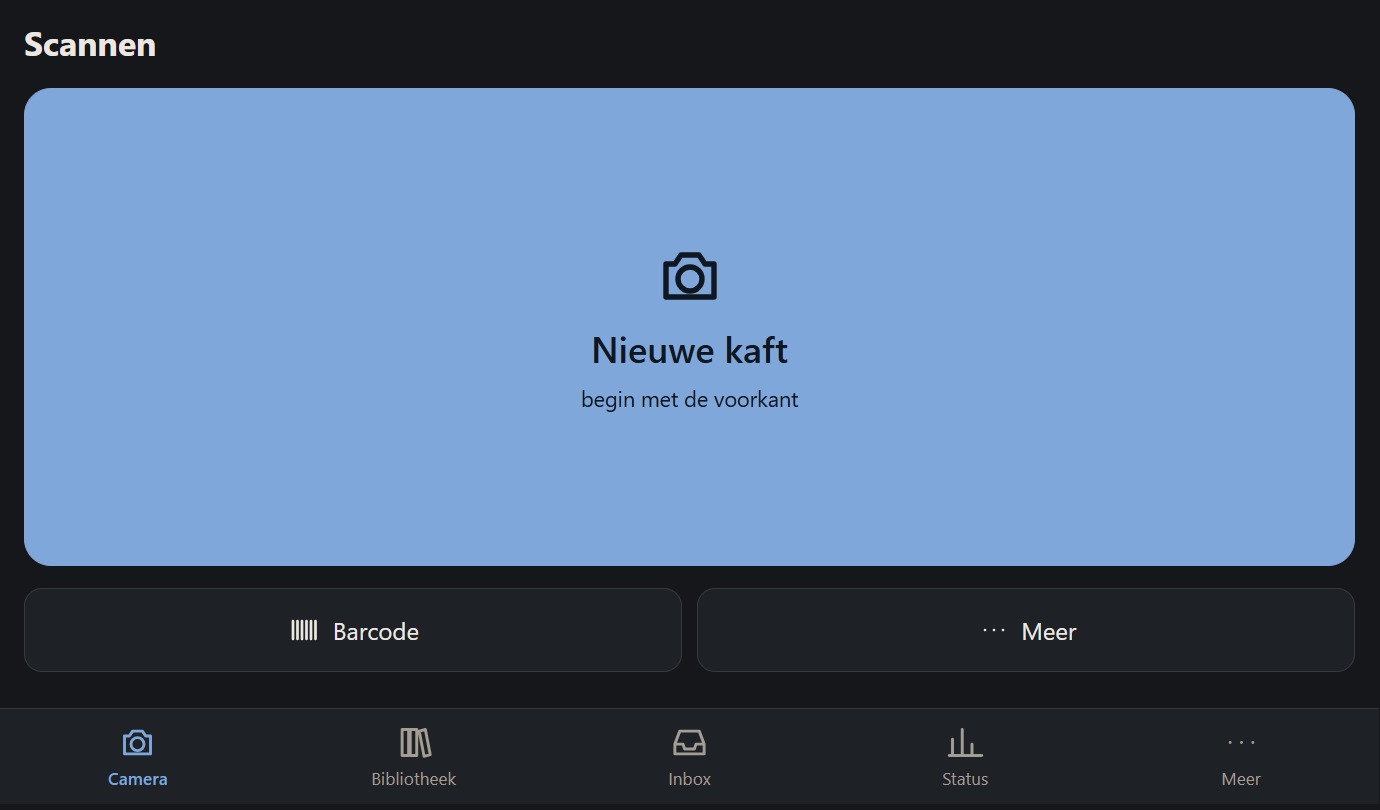
De app is ontworpen voor gebruik met een telefoon. Ik begin met de voorkant van een boek. Daarna kan ik, zolang de scan-sessie openstaat, foto's van de achterkant, barcode of het colofon maken. Die horen automatisch bij dezelfde kaft, zodat ik niet achteraf een stapel losse foto's hoef uit te zoeken.
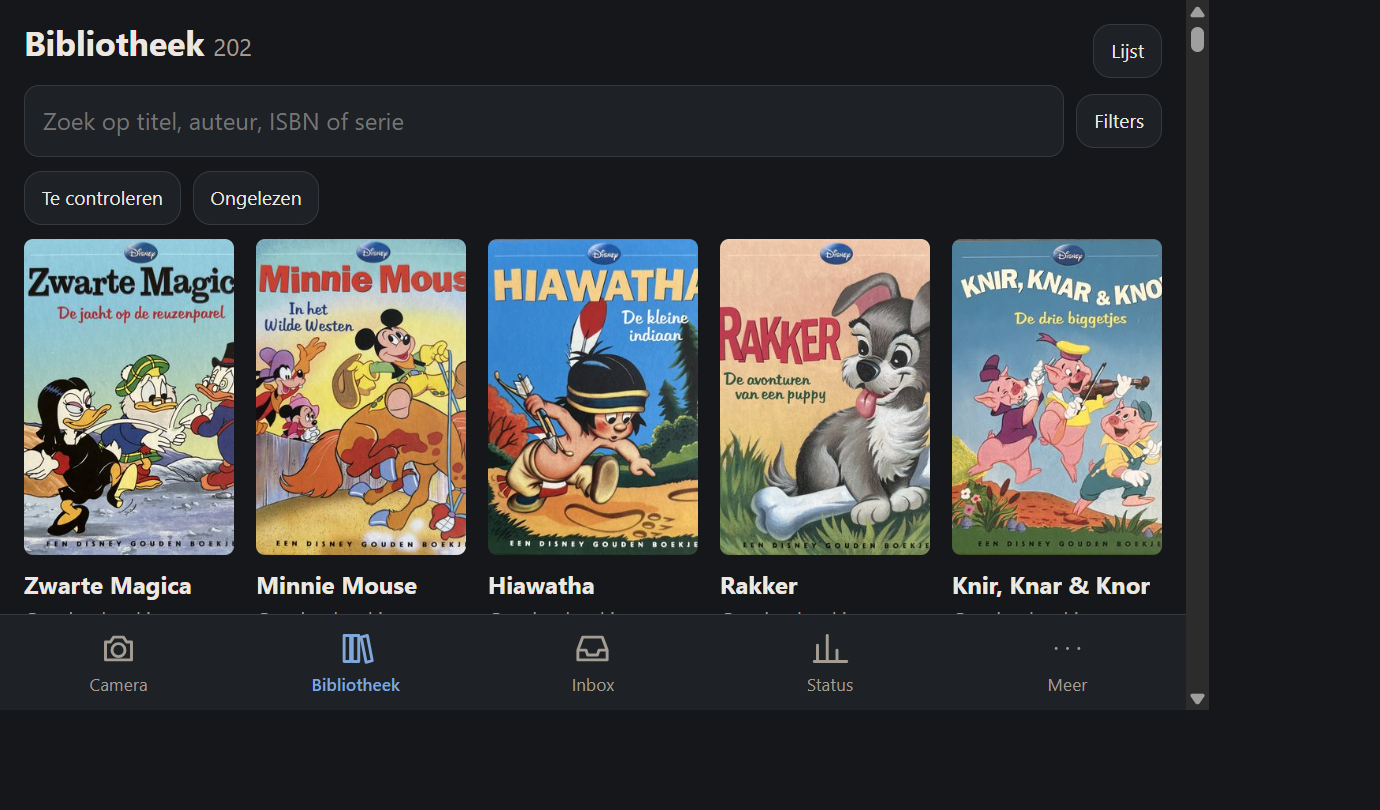
Ook als de verbinding even wegvalt, blijft een gemaakte foto in een uploadwachtrij op de telefoon staan. Een boek zonder foto toevoegen of een losse foto uit de galerij gebruiken kan ook. In de bibliotheek kan ik vervolgens zoeken op titel, auteur, ISBN of serie en filteren op bijvoorbeeld locatie, gelezen status of boeken die nog gecontroleerd moeten worden.
Niet elke foto is dezelfde taak
Een van de belangrijkste keuzes is dat ik het model niet iedere foto dezelfde vraag stel. Een kaft, barcode en colofon bevatten andere informatie en vragen om een andere aanpak.
- Kaft: een vision-model leest titel, ondertitel en auteur. Een uitgeverslogo wordt niet zomaar als boektitel overgenomen.
- Barcode of achterkant: lokale barcodeherkenning en OCR zoeken naar het ISBN; de achterkant wordt niet gebruikt om de titel opnieuw te verzinnen.
- Colofon: OCR leest eerst de kleine tekst. Daarna helpt het taalmodel die te ordenen in uitgever, druk, oorspronkelijke titel, vertaler en reeks.
Die verdeling houdt het werk doelgericht. Een vision-model is goed in het begrijpen van een kaft, maar een kleine ISBN-regel is juist geschikt voor OCR en controle van het ISBN-controlecijfer. Voor barcodeherkenning en OCR is LM Studio niet nodig; die blijven dus werken wanneer de pc met het vision-model uitstaat.
De server zet herkenningswerk in een wachtrij en controleert periodiek of LM Studio bereikbaar is. Zodra het model weer beschikbaar is, kan de verwerking verder. Foto's verdwijnen dus niet omdat mijn AI-pc op dat moment niet aanstaat.
Gegevens samenvoegen zonder ze kwijt te raken
Een herkend ISBN kan catalogusgegevens opleveren, maar een ISBN-lookup is niet automatisch de waarheid. Catalogi koppelen soms een verkeerde editie of titel aan een nummer. Daarom accepteert de app zo'n aanvulling alleen als de informatie bij de kaft past.
Per veld is de voorkeursbron vastgelegd. Mijn eigen handmatige invoer wint altijd. Titel en auteur komen bij voorkeur van de kaft; het ISBN van de barcode en anders van OCR; uitgever, druk en vertaler uit het colofon. Open Library en Google Books vullen aan waar dat betrouwbaar kan. Bij elk veld zie ik de bron, zoals AI, gelezen, catalogus of handmatig.
Bij koppelen geldt dezelfde voorzichtigheid. Een foto kan op ISBN of op titel en auteur aan een bestaand boek worden gekoppeld. Een sterke match mag automatisch, maar twijfel wordt een voorstel in de Inbox. Een mogelijk dubbel boek wordt nooit stilzwijgend samengevoegd. Zo kan automatisering tijd besparen zonder de collectie ongemerkt te veranderen.
Ook bij een slecht leesbaar of fout gedrukt controlecijfer gooit de app het ISBN niet weg: het wordt bewaard en als aandachtspunt getoond. De originele foto blijft eveneens byte voor byte behouden. Een gecorrigeerde uitsnede of vrijstaande kaft is een extra versie, niet een vervanging van het origineel.
De stack en lokale verwerking
De backend bestaat uit Python, FastAPI, SQLAlchemy en SQLite. De frontend is gebouwd met Svelte 5, TypeScript en Vite en kan als PWA op een telefoon worden geïnstalleerd. De app en de gegevens draaien samen in Docker; de database en foto's staan in een volume dat ik kan back-uppen.
De herkenning gebruikt een OpenAI-compatibele lokale API van LM Studio. Voor ISBN-gegevens kijkt de app bij Open Library en eventueel Google Books; daarvoor kan ik een eigen API-key instellen. OCR draait lokaal met RapidOCR. Optioneel kan ComfyUI op mijn netwerk foto's rechtzetten en de achtergrond van een boek verwijderen. Als ComfyUI uitstaat, probeert de app lokaal randdetectie; bij twijfel houdt hij liever het origineel dan een verkeerd uitgesneden foto.
Die onderdelen zijn bewust niet allemaal één grote AI-aanroep. Een ISBN opzoeken is een catalogusvraag, een barcode lezen is beeldherkenning en een kaft interpreteren is een vision-taak. Door elk onderdeel apart te houden, kan de app bruikbaar blijven als een van de diensten tijdelijk niet beschikbaar is.
Thuisnetwerk, HTTPS en backups
De app heeft geen login en is daarom uitsluitend bedoeld voor mijn thuisnetwerk of VPN. Ik zet de poort niet open naar het internet. Voor gebruik via een reverse proxy heb ik HTTPS nodig voor functies zoals live scannen met de camera en het installeren van de volledige PWA op Android.
De data is te exporteren als CSV of JSON, of als volledige ZIP-backup met foto's en thumbnails. Bij import worden bestaande boeken en foto's niet overschreven; alleen ontbrekende gegevens worden toegevoegd. Daarmee kan ik een backup herhaaldelijk importeren zonder dat een bestaande collectie steeds opnieuw verandert.
De technische opzet past goed bij de rest van mijn homelab: één Docker-app op mijn eigen server, met de zwaardere vision-verwerking op een pc die niet continu aan hoeft te staan.
Resultaat
Het resultaat is geen magische scanner die elk boek foutloos begrijpt. Het is een invoerproces waarin de camera het startpunt is, verschillende herkenningsmethodes hun eigen werk doen en ik kan terugzien wat automatisch is ingevuld en waarom.
Dat is voor mij de juiste balans: minder overtypen, maar geen gegevens of foto's kwijtraken en geen twijfelachtige matches verstoppen. De collectie blijft controleerbaar, ook als OCR, een catalogus of het taalmodel er een keer naast zit.
Vragen / feedback
Als je vragen hebt over de herkenningspipeline, de lokale verwerking of het back-upformaat, stel ze dan via mijn contactformulier en ik neem contact met je op.